这三个指标经常被混着说,含义却完全不同。
MTTF(Mean Time To Failure)用于不可修复产品,比如一只电容、一个光模块。它表示到失效为止的平均工作时间。
MTTR(Mean Time To Repair)是平均修复时间,包含故障定位、备件替换、恢复验证。它决定了故障发生后要瘫多久。
MTBF(Mean Time Between Failures)用于可修复产品,是两次故障之间的平均时间。它的数学定义是失效率 λ 的倒数:MTBF = 1 / λ。
注意最后这句的分量。MTBF 是从「失效率」反推出来的量,它描述的是统计意义上的失效频率,而不是某台设备的寿命上限。一台 MTBF 20 万小时的交换机,可能第二天就坏,也可能用满十年;MTBF 说的是在大量设备的统计平均下,每 20 万设备小时发生一次失效。
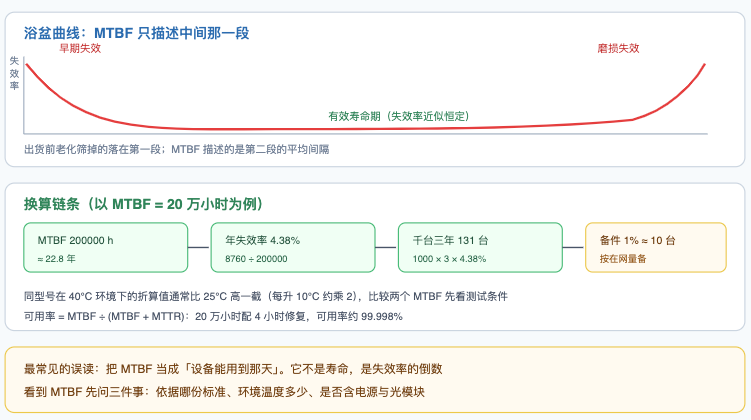
一年按 8760 小时算(365 × 24)。三个换算放在一起看:
20 万小时 ÷ 8760 小时/年 ≈ 22.8 年。这个数字容易让人误读成寿命。
年失效率 λ = 8760 ÷ 200000 = 4.38%。这才是能用的工程量。
月失效率 λ = 730 ÷ 200000 = 0.365%。
再看另一个量级对比。10 万小时的 MTBF 对应年失效率 8.76%,30 万小时对应 2.92%。所以在参数表上「MTBF 从 15 万提到 30 万」意味着把期望年失效率从 5.84% 砍到 2.92%,也就是故障率降一半,而不是「寿命翻倍」。
现场条件:某市部署 1000 台工业交换机,厂商标称 MTBF 20 万小时,质保三年(按 3 × 8760 = 26,280 小时)。
第一步,三年内单台的期望失效次数:26,280 ÷ 200,000 = 0.1314 次。用指数分布更严谨的算法 1 − e^(−0.1314) = 0.1231,两者在低失效率下差别不大,取 0.13。
第二步,1000 台的期望返修台数:1000 × 0.1314 ≈ 131 台。也就是说三年累计返修 131 台,平均每年约 44 台。
第三步,备件池。行业常见的做法是按在网量的 0.5%~1% 储备。1000 台 × 1% = 10 台。这个数字和 131 台的累计返修并不矛盾——备件是用于快速替换的周转库存,坏掉的设备修好后回池,只要维修周期短于故障间隔,10 台足以维持周转。
第四步,把这个数字套到运维预算上:131 台返修,如果单次返修成本(含物流、人工、检测)按 300 元估算,三年累计约 3.93 万元;换成 MTBF 30 万小时的机型,三年期望返修 1000 × 26,280 ÷ 300,000 ≈ 88 台,累计约 2.64 万元,三年差出约 1.3 万元。如果换机型每台贵 50 元,1000 台多支出 5 万元——这笔账在两三年内是算不平的。
这个算例说明一件事:可靠性指标要放到具体规模和时间轴上才有意义。单台比较看不出来,千台三年立刻分出差别。
第一个变量是依据的标准。MIL-HDBK-217F 是最早广泛使用的应力分析法,基于上世纪美军器件数据,对现代集成器件的失效率估计偏保守,算出来的数字往往偏低(也就是看起来更差)。Telcordia SR-332 是通信行业的做法,1990 年代以后成为主流,方法里对器件、温度、应力的建模不同,同一台设备用两套标准算出来的数字可以有明显差别。还有一类是厂商基于实测数据的现场统计,口径又不一样。
第二个变量是环境温度。MIL-HDBK-217F 与 SR-332 都使用温度加速模型,常见的近似结论是每升高 10℃ 失效率约翻倍,对应激活能 Ea ≈ 0.7 eV 量级。按这个近似,同一台设备在 40℃ 环境下的折算失效率大约是在 25℃ 下的 2.8 倍(温差 15℃,约 1.5 个「10℃」台阶)。
第三个变量是统计范围。MTBF 是否包含电源模块?是否包含风扇、光模块这类可插拔件?是否包含整机线缆与接插件?口径不同,结果差得很远。一台无风扇设备与一台带风扇设备,在同样的主板上算 MTBF,前者通常会明显更好,因为风扇是机械件,失效率通常高于板级器件。
| 参数表上的写法 | 需要追问的问题 | 影响 |
|---|---|---|
| MTBF 20 万小时 | 依据 MIL-HDBK-217F 还是 SR-332 | 同一实测水平可差出数倍 |
| 未标注环境温度 | 25℃ 还是 40℃ 环境 | 15℃ 温差约对应 2.8 倍差异 |
| 未标注统计范围 | 是否含电源、光模块、风扇 | 含风扇时通常显著变差 |
| 只给「平均无故障时间」 | 是 MTBF 还是 MTTF | 不可修复器件才有 MTTF |
| 未标注置信度 | 60% 还是 90% 置信水平 | 同一数据不同置信度结果不同 |
失效率随时间的分布近似一条浴盆形状,分三段:
早期失效段:出货后最初几百小时,失效率较高,主要来自焊接不良、器件本身缺陷、装配应力。这一段是可以被主动筛掉的——出货前做老化(burn-in)通电运行,把有隐患的设备暴露出来,代价是占用测试工位和通电时间。
有效寿命段:失效率近似恒定,MTBF 描述的就是这一段。这一段的长短取决于器件工艺与工作温度。
磨损失效段:接近寿命末期,机械件(风扇、继电器)、电解电容、光模块的激光器等开始退化,失效率快速上升。这也是「工业设备五年一换」这类经验说法的来源。
老化筛选的价值在于把第一段的失效提前到工厂里发生。对采购方来说,可以问的问题很直接:出厂前是否做老化,做多久,温度是多少。老化 24 小时与 72 小时的差别,会直接体现到现场首年返修率上。
可用率 A = MTBF ÷ (MTBF + MTTR)。
取 MTBF 20 万小时、MTTR 4 小时:A = 200000 ÷ 200004 ≈ 99.998%,对应年不可用时间约 10.5 分钟。
换成 MTTR 24 小时(需要等工程师到场、等备件快递):A = 200000 ÷ 200024 ≈ 99.988%,年不可用时间升到约 63 分钟。
MTBF 差一倍只让可用率动小数点后几位,MTTR 从 4 小时变成 24 小时却能让不可用时间增加 5 倍。这就是为什么在工业现场,备件池与响应速度的收益往往大于把 MTBF 从 20 万提到 30 万:前者直接把 MTTR 从 24 小时压到 4 小时,后者只改善了几个小时里的期望故障次数。
想进一步提升可用率,手段是冗余而不是挑指标:双电源、环网保护、双上行。这些机制让单点故障不产生业务中断,等效于把 MTTR 变成 0,收益远大于参数表上的数字游戏。
| 序号 | 提问 | 期望回答 |
|---|---|---|
| ① | MTBF 依据哪份标准 | 明确到 MIL-HDBK-217F 或 Telcordia SR-332 版本 |
| ② | 对应的环境温度是多少 | 25℃ 或 40℃,或注明是「实测环境」 |
| ③ | 是否包含电源、风扇、光模块 | 逐项说明,不含的单独给 |
| ④ | 出厂是否做老化,条件是什么 | 时长、温度、上电程度 |
| ⑤ | 质保期内的实际返修率是多少 | 现场数据比理论值更有参考性 |
第五个问题的价值最高。理论 MTBF 可以被算法调优,返修率不行。一台标称 20 万小时、实际年返修率 5% 的设备,和一台标称 15 万小时、实际年返修率 1.5% 的设备,后者在现场更省心。
锐应科技在工业交换机与光接入产品上采用无风扇设计,减少机械失效率最高的部件,产品线与技术规格见 工业交换机方案页;光接入侧设备(mini GPON OLT 与 XPON ONU)的部署可靠性设计参见 PON 接入方案。
不能。22.8 年只是把小时数换算成年份的结果,用于帮人建立量级感。正确理解是:年失效率约 4.38%,1000 台设备一年期望失效约 44 台,平均每台设备每 22.8 年失效一次。这两个说法在统计上等价,但后者不会让人误以为设备有「寿命上限」。
常见原因有三个:一是标准与温度条件不同,25℃ 下算出来的数字放到 45℃ 的机柜里,实际失效率约翻倍甚至更多;二是统计范围不同,含风扇与光模块的口径会更差;三是实际工作条件不同——电压波动、湿度、粉尘、振动都会加速失效,而这些不在任何 MTBF 公式里。所以选型时应该把现场环境温度写进询价条件,让厂商按实际条件给数。
按在网量的 0.5%~1% 起步,再根据维修周转时间调整。周转时间是关键变量:如果坏件返厂维修要 30 天,而按 MTBF 算出的月故障数接近备件数量,池子就会被掏空。经验算法是备件数 ≥ 月故障数 × 维修周转月数 × 1.2 的安全系数。以千台、年故障 44 台为例,月故障约 3.7 台,维修周转 1 个月,备件池至少 5 台;如果周转要 3 个月,就要 14 台左右。
能降低首年返修率,尤其是早期失效那部分。行业内常见的做法是出厂前通电老化,把焊接不良、器件早期缺陷这类问题在工厂暴露出来。对采购方来说,值得问清老化的时长、温度与上电条件——只做 4 小时常温通电与做 48 小时高温老化,筛掉的比例差别很大。代价是这部分成本最终会体现在单价上,属于用价格换早期返修率。
优先级取决于故障代价。如果一次故障只是让办公网断几分钟,那就该把精力放在提高 MTBF、降低返修率上;如果一次故障会造成产线停机或监控录像丢失,那冗余的收益更高——双电源、环网保护、双上行能让单点失效不中断业务,等效于把 MTTR 压到 0,效果是 MTBF 提升几倍都给不了的。多数工业项目的实际情况是两者都要做,但顺序应该是先冗余、后指标。
MTBF 是一个被误读了太多次的指标。它的用途是把「可靠性」翻译成可以参与决策的数字:年失效率、三年期望返修台数、备件池规模。真正影响现场体验的却是另外两件事——厂商按什么条件给出这个数字,以及你的运维体系能不能在设备坏掉后 4 小时内换掉它。把换算做一遍、把询价问题列清、把冗余做在关键路径上,比在参数表上比较大小有用。产品规格与可靠性设计说明见 关于锐应。