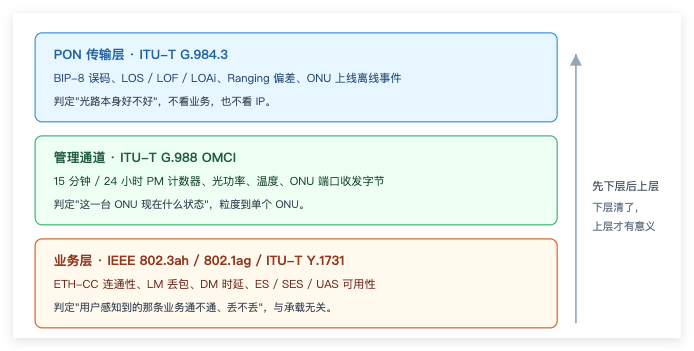
PON 网络里的性能数据来源有三处,对应三个层次。
PON 传输层:ITU-T G.984.3 定义的帧结构与告警,包括 BIP-8 校验、LOS(信号丢失)、LOF(帧丢失)、LOAi(激活失败),以及 ONU 的测距偏差。这一层只看光路和 PON 帧本身,不关心承载的是什么业务。
管理通道:ITU-T G.988 定义的 OMCI 性能管理,按 15 分钟和 24 小时两个粒度上报计数器,覆盖 ONU 的收发字节、误帧、光功率、温度、端口状态。这一层能看到单台 ONU 的细节。
业务层:IEEE 802.3ah(EFM OAM)、IEEE 802.1ag(CFM)、ITU-T Y.1731 定义的连通性与性能测量,用 ETH-CC 测连通、LM 测丢包、DM 测时延,最终折算成 ES/SES/UAS 这类可用性指标。
三层的关系是:下层不清,上层的数就没有解释力。 光路有误码时,业务层看到的丢包是结果不是原因;反过来,光路干净而业务层丢包,问题多半在 VLAN、队列或上游。
| 层次 | 标准 | 主要读数 | 回答的问题 | 统计粒度 |
|---|---|---|---|---|
| PON 传输层 | ITU-T G.984.3 | BIP-8、LOS/LOF/LOAi、测距偏差 | 光路本身好不好 | 每个 PON 口 |
| 管理通道 | ITU-T G.988 OMCI | 15 分钟/24 小时 PM、光功率、温度 | 这台 ONU 现在什么状态 | 单台 ONU |
| 业务层 | 802.3ah / 802.1ag / Y.1731 | ETH-CC、LM 丢包、DM 时延、ES/SES/UAS | 用户那条业务通不通、丢不丢 | 每条业务 |
BIP-8 是 G.984.3 里的比特间插奇偶校验,每个下行帧带 1 字节校验,接收端算一遍比对。它抓的是"这一帧在传输过程中有没有出错",不是"业务有没有丢包"。
读 BIP-8 计数要注意两点:
其一,它统计的是误码块,不是误码比特。 一个块里错 1 bit 和错 8 bit 都记 1 次。所以不能用它算 BER,只能看趋势。
其二,它分方向。 下行 BIP-8 由 ONU 检测并上报,反映 OLT 到 ONU 的方向;上行由 OLT 检测,反映 ONU 到 OLT。只有单向涨,说明问题在特定方向的光路或模块,不是"整条链路都不好"。
LOS 和 LOF 是硬告警,含义比误码严重:LOS 表示收不到光,LOF 表示收到光但帧不同步。这两个告警一旦出现,该 ONU 的业务就是断的,不需要再去看误码计数。
实际排查里,BIP-8 的价值在于区分"光路劣化"与"业务配置错误"。BIP-8 平稳而用户报丢包,基本可以排除光路;BIP-8 持续增长,先查光衰和模块,别去改 VLAN。
G.988 的 PM 计数按 15 分钟一个桶上报,24 小时由 96 个桶合成。这个设计的好处是粒度细、能看到趋势;坏处是计数器会溢出。
以 32 位字节计数器为例,最大值 2³² − 1 = 4,294,967,295 字节。在 1.244 Gbps 的上行满速下,每秒约 155 MB:
4,294,967,295 ÷ 155,000,000 ≈ 27.7 秒
也就是说,32 位计数器在满速下不到 28 秒就回绕一次。 一个 15 分钟的桶(900 秒)里会回绕 32 次,如果设备用 32 位存计数,读出来的值毫无意义。
所以工程上有两个要求:PM 计数器必须是 64 位,或者设备在桶内做多次采样累加。 选型时问一句"PM 计数是 32 位还是 64 位",能避免后期排查时的假数据。
另一个容易忽略的点:桶是滚动覆盖的。 大多数设备只保留最近的若干个 15 分钟桶(常见 96 个,即 24 小时)。故障发生在两天前,桶已经被覆盖,只能看 24 小时汇总。要长期趋势,得靠网管定期采集入库,不能指望设备自己存。
用户说"卡",工程上要翻译成可测量的指标。ITU-T Y.1731 与 G.826 体系里,三个指标最常用:
ES(Errored Second,误帧秒):1 秒内出现至少 1 个错误块,这一秒记为 ES。 SES(Severely Errored Second,严重误帧秒):1 秒内错误块占比达到或超过 30%,记为 SES。 UAS(Unavailable Second,不可用秒):连续 10 个 SES 之后进入不可用状态,这段秒数记 UAS。
三者的关系是递进的:ES 统计"有错的秒",SES 统计"错得很惨的秒",UAS 统计"已经不可用的秒"。可用率 = (总秒数 − UAS) ÷ 总秒数。
用这三个指标的好处是可比。不同业务、不同厂商、不同链路,都能折算到同一个尺度上;而且它们和 SLA 条款直接对应,运营商合同里写的"可用率 99.9%"就是按 UAS 算的。
一根主干光纤断了,OLT 上会发生什么?128 个 ONU 全部 LOS,每个 ONU 的 3 个业务各报一条,加上端口 down、VLAN 失效,网管上瞬间几百条告警。值班人员真正的故障点只有一个,却要在几百条里找。
告警抑制(alarm suppression)与根因归并(root cause analysis)解决这个问题:
抑制:某个告警存在时,屏蔽由它衍生的下级告警。LOS 存在时,该 ONU 的"业务中断""光功率过低"不再上报。
归并:把同一根光纤、同一个分光器下的多条告警聚合成一条,标注影响范围(如"ODN 分支 3,影响 12 台 ONU")。
配置要点是先定义层级,再定义抑制关系。层级通常是:光纤/端口 → ONU → ONU 的 UNI 口 → 业务。上层告警出现时,下层自动抑制;上层恢复后,下层告警要重新评估,不能简单恢复上报,否则会二次刷屏。
这件事听起来是网管软件的功能,实际效果取决于设备侧有没有把"告警之间的父子关系"暴露出来。只报"ONU 断",不报"断在哪个分光分支",网管再聪明也归并不了。
一条 1:128 的 PON 口,用户陆续报"晚上卡"。取某个 15 分钟桶的数据。
已知:窗口 900 秒;该桶内 12 秒存在误帧;这 12 秒里有 3 秒的错误块占比超过 30%;上行 BIP-8 计数增长明显高于下行。
第一步,算 ES。
ES = 12 秒
ES 占比 = 12 ÷ 900 = 1.33%
第二步,算 SES。
SES = 3 秒(这 3 秒错误块占比 ≥30%)
第三步,判断 UAS。
UAS 要求连续 10 个 SES,这里只有 3 个且不连续,所以 UAS = 0。
第四步,算可用率。
可用率 = (900 − 0) ÷ 900 = 100%(严格按 UAS 口径)
按 ES 口径的"无错秒占比" = (900 − 12) ÷ 900 = 98.67%
第五步,看方向。
上行 BIP-8 增长高于下行 → 问题在 ONU 到 OLT 方向。结合"晚上卡"的时间特征,优先怀疑上行突发碰撞或某个 ONU 发光异常,而不是下行光衰。
结论:这是一个"性能劣化"而不是"业务中断"的案例。门限若设 ES 占比 1%,1.33% 已经越线,应告警;但 UAS = 0 说明业务没断,不需要派单上门,先做远程排查(看单 ONU 上行字节数、光功率趋势)。
| 指标 | 本例读数 | 建议门限 | 判定 |
|---|---|---|---|
| ES 占比 | 1.33% | 15 分钟 >1% | 越线,告警 |
| SES | 3 秒 | 15 分钟 >0 | 越线,关注 |
| UAS | 0 | >0 | 正常 |
| 上行 BIP-8 | 高于下行 | 单向增长即异常 | 指向 ONU 侧 |
| 无错秒占比 | 98.67% | >99.5% 为健康 | 偏低 |
门限不是固定值。视频业务对丢包不敏感(有缓冲),语音和游戏对时延抖动敏感,工业控制对丢包零容忍。同一组计数,不同业务要有不同门限,否则要么天天误报,要么真出事不报。
只采 24 小时汇总。 24 小时桶把夜间故障和白天故障平均掉了,看不出"晚高峰劣化"这类规律。至少保留 15 分钟粒度 7 天。
只看告警不看计数。 告警是二值的(有/无),计数是连续的。光功率从 −22 dBm 缓慢降到 −26 dBm,在告警门限上没触发,但已经逼近灵敏度极限,这时候计数(误码、重传)会先动。
门限全网红一刀切。 不同分光比、不同距离的 PON 口,基线本来就不同。1:128 与 1:32 的误码基线差一个量级,用同一个阈值必然误报。按 PON 口分组设门限,是成本最低的改进。
PON 上联若由工业交换机承载,交换机的端口计数与光模块 DDM 可以作为第二个观测面:PON 侧看到的是 ONU 到 OLT 的误码,上联侧看到的是 OLT 到城域的丢包与光功率,两者对不上时问题多半在 OLT 内部。设备侧的端口统计能力见 工业交换机方案。
锐应 L102P 这类 mini GPON OLT 通过 OMCI 管理 ONU,性能计数按 15 分钟与 24 小时两个粒度提供;具体到每个计数器的位宽与保留桶数,要按软件版本核对。ONU 侧的光功率与温度也在同一套 OMCI 通道里,配合 PON 方案页 里的设备规格,可以把"光路—ONU—业务"三段数据对齐。
不一定。BIP-8 统计的是 PON 帧的校验结果,OLT 或 ONU 的收发器在临界状态下(比如收光接近灵敏度、模块温度过高)也会产生误码,不一定是光纤断或熔接点劣化。判断方法:看是单向还是双向、看是否与温度相关、看换模块后计数是否跟着走。
不是。ES 是按秒计的"有错秒",丢包率是按包计的百分比。1% 的 ES 可能对应很低的丢包率(每秒只错一个包),也可能对应很高的丢包率(错的那一秒丢了 30%)。做 SLA 用 ES/SES/UAS,做容量分析用丢包率,两者不能互相替代。
大概率是 32 位回绕。1.244 Gbps 满速下,32 位字节计数器不到 28 秒就绕一圈,900 秒的桶里会绕 30 多次。要求设备用 64 位计数,或者确认它在桶内做了累加。选型阶段就该问清楚,事后没法补。
靠抑制与归并,不能靠人眼筛。设备侧要能把"光纤 → ONU → UNI 口 → 业务"的层级关系暴露给网管,网管才能在上层告警出现时屏蔽下层。如果设备只报孤立告警,先按 ONU-ID 分组看,同一时刻大量 ONU 同时 LOS,基本就是主干或分光器侧的问题。
可以,用 Y.1731 的 DM(Delay Measurement)功能,在两端设备上发测量帧,得到单向或双向时延。前提是两端都支持该功能,且时间同步精度足够(单向测量需要同步,双向不需要)。没有这个能力时,退而求其次用 ping 看 RTT 趋势,精度差但能发现突变。
性能监测的价值不在于多采集几个数,而在于把"用户说卡"翻译成"哪个 PON 口、哪台 ONU、哪个方向、持续多久"。三层数据各管一段:PON 层摘光路,OMCI 层定 ONU,业务层对 SLA。真正拉开运维水平差距的是门限——按分光比和业务类型分组设阈值,比买一套昂贵的网管更有效。设备侧的方案与规格见 锐应官网。