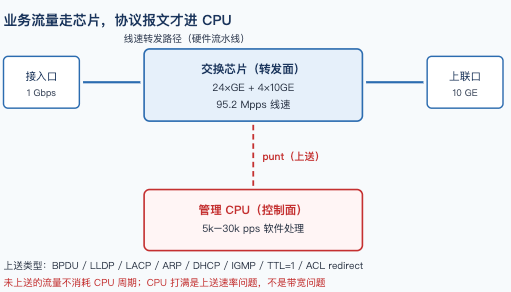
一台标称 24 口千兆加 4 个万兆上联的交换机,包转发率标 95.2 Mpps。这个数字说的是交换芯片的能力,与那颗几百兆赫兹的管理 CPU 没有关系。芯片的转发路径不经过操作系统,CPU 挂了业务流量照样通——反过来,CPU 被打满时业务也可能完全正常,只是你 telnet 不上去了。
转发面由 ASIC 或交换芯片实现,查 MAC 表、查路由表、改 VLAN Tag、算校验和,全部是硬件流水线,单周期完成。8 口千兆的线速包转发率是 8 × 1.488 = 11.9 Mpps;24 口千兆加 4 个万兆是 24 × 1.488 + 4 × 14.88 = 95.2 Mpps。这些数字是芯片在最小帧(64 字节)下的理论上限。
转发面跑满的表现是丢包,不是 CPU 高。判断方法看 ifOutDiscards 计数:如果某个出端口在持续增长,而同端口 CPU 占用正常,说明是拥塞或芯片队列溢出,跟控制面无关。反过来,如果 CPU 高但所有端口计数器都干净,说明上送流量大但转发不受影响。
这条区分很重要,因为它决定了排查方向。看到"网络卡"就去查 CPU,方向一开始就错了;转发面的问题要看队列、缓存和链路利用率。
交换芯片只做规则明确的事。任何需要"看懂内容"或"生成回复"的报文,都必须上送到 CPU 处理,这个动作叫 punt。常见的上送类型有七类:
第一类,目的 MAC 是交换机自身。管理 IP 的 ping、telnet、ssh、SNMP、HTTP,全部要 CPU 处理。这类流量与业务流量共享同一批端口,但走不同的通道。
第二类,二层协议报文。BPDU(802.1D/RSTP/MSTP)、LLDP(802.1AB)、LACP(802.3ad)、GVRP/MVRP、ERPS/MRP 的协议帧,目的 MAC 都是保留组播地址,芯片识别后直接上送。
第三类,广播和特定组播。ARP 请求、DHCP Discover、IGMP Report 都属于这一类。注意不是所有广播都上送——芯片通常只上送协议相关的,普通广播由硬件泛洪。
第四类,TTL 等于 1 或 TTL 过期的 IP 包。芯片会把它们上送,让 CPU 回 ICMP Time Exceeded。
第五类,IP 选项和分片。带 option 的 IP 头、非首片分片,硬件不好处理,转给软件。
第六类,ACL 重定向到 CPU。策略路由、流量镜像到 CPU、以及某些安全策略会主动把包指向上送通道。
第七类,未知目的 MAC 的单播。这一条取决于芯片实现,多数平台由硬件泛洪而不上送,但有些平台在 MAC 表满之后会转为上送,这时候性能会断崖式下降。
| 报文类型 | 处理面 | 上送原因 | 建议限速(示意) |
|---|---|---|---|
| 目的 MAC 为本机(SSH/SNMP/HTTP) | 控制面 | 需要协议栈处理 | 200 pps |
| BPDU(STP/RSTP/MSTP) | 控制面 | 生成树计算 | 100 pps |
| LLDP / LACP | 控制面 | 邻居与聚合协商 | 100 pps |
| ARP 请求与应答 | 控制面 | 软件查表回包 | 300 pps |
| DHCP / IGMP | 控制面 | Snooping 与中继 | 200 pps |
| TTL=1 / IP option | 控制面 | 生成 ICMP 差错 | 50 pps |
| 普通业务流量 | 转发面 | 不需要上送 | 不限 |
第一条是广播风暴。没有生成树或者生成树失效的环网,一个广播帧会在环里循环放大,每绕一圈乘一次端口数。8 口全千兆的环,理论放大倍数能到 7 的 N 次方。即便芯片只上送协议类广播,ARP 请求也会以线速涌向 CPU。这种情况下 CPU 占用会在几秒内冲到 100%,业务同时瘫痪。
第二条是 ARP 洪泛。终端侧有故障设备持续发 ARP 请求,或者网段里有地址扫描工具在跑。ARP 是软件处理的,每个请求都要查表、组包、回发,单包成本远高于转发。
第三条是管理面滥用。SNMP 轮询间隔设成 10 秒、一次 walk 几百个 OID;syslog 把每个包的日志都发出去;网管平台同时开五六个采集任务。这些都不是"故障",但累积起来能占掉一半 CPU。
第四条是协议攻击或误配。BPDU flood、大量伪造的 DHCP 请求、IGMP Report 风暴,都属于这一类。它们的共同点是不产生业务流量,却让 CPU 忙于处理协议。
CoPP(Control Plane Policing)的思路是给每类上送报文设独立的速率上限,超出的直接丢弃。它是控制面唯一有效的保护手段,但用得不好会反噬。
典型反噬是 BPDU 被限速。如果 BPDU 的限速设成 50 pps,而环网里有 60 个端口在发,每秒就有 10 个 BPDU 被丢。丢掉的可能是拓扑变更通知,结果就是生成树收敛变慢或者干脆不收敛。BPDU 的限速必须按端口数乘出来,再留 30% 余量。
第二个反噬是分类过粗。把 ARP、DHCP、IGMP 全部归到"其他 IP"一类共用一个 500 pps 的桶,DHCP 洪泛会把这个桶打满,ARP 跟着被丢,全网瞬间失联。分类必须按协议分开,各自独立限速。
第三个边界是 CoPP 只保护 CPU,不解决根因。开了 CoPP 之后 CPU 占用降下来了,但广播风暴还在,转发面照样被吃掉。CoPP 的价值是"让管理面活着,好让你进去修",不是修复本身。
一个 500 台终端的接入网,正常情况每台终端每 2 秒发 1 个 ARP(网关探测加免费 ARP),ARP 上送速率是 500 / 2 = 250 pps。假设 CPU 的处理能力是 20k pps,ARP 占 1.25%,可以忽略。
现在加一台故障终端,以 1000 pps 持续发 ARP 请求。总量变成 1250 pps,占 CPU 6.25%。仍然不高,但 ARP 的处理路径是软件查表加组包回发,单包消耗的周期大约是普通转发的 20 倍。按等效负载算,1250 pps × 20 = 25000 等效 pps,已经超过 20k pps 的处理能力,CPU 开始丢包。这就是为什么 6% 的"包速率占比"能造成 100% 的"CPU 占用"——占比算错了分母。
再算广播风暴。8 口千兆环网,线速 11.9 Mpps。假设其中 5% 是 ARP 广播并被上送,上送速率 = 11.9M × 5% = 595k pps。这个数字是 CPU 能力的 30 倍。此时 CPU 完全瘫痪,SSH 进不去,SNMP 超时,只能靠 console 口现场处理。
两个算例指向同一个结论:控制面的瓶颈不在带宽,在"每秒处理多少个需要软件参与的包"。250 pps 无害,1250 pps 濒临,595k pps 直接击穿。中间没有缓冲。
三个动作能快速区分。
先看丢包位置。ifOutDiscards 增长说明出端口队列溢出,是转发面拥塞;ifInDiscards 增长且 CPU 高,说明上送通道被打满。两个计数都干净但业务慢,问题在链路或对端。
再看分层测试。从同网段 ping 网关(走 CPU)和 ping 跨网段大流量设备(走转发面),如果前者丢包后者正常,基本锁定控制面;反之锁定转发面。
最后看协议计数。BPDU 收发计数、ARP 请求计数、DHCP 报文计数,哪个异常增长就是哪条路径被打满。
| 症状 | 可能原因 | 验证手段 | 处置 |
|---|---|---|---|
| CPU 95% 且 SSH 卡顿 | 广播风暴 / ARP 洪泛 | 查上送分类计数与广播速率 | 先开 CoPP 保管理面,再查环路 |
| CPU 正常但业务丢包 | 转发面拥塞 | 查 ifOutDiscards 与队列水位 | 扩容上联或调 QoS |
| 特定协议不通,其他正常 | 该协议被 CoPP 误限 | 查该类计数是否有丢包 | 上调该类限速桶 |
| 凌晨固定时段 CPU 尖峰 | 网管轮询 / 备份任务 | 对比任务时间表与 CPU 曲线 | 错峰或降低轮询频率 |
| MAC 表满后性能断崖 | 未知单播上送 CPU | 查 MAC 表项数与学习限制 | 配 MAC 学习上限与老化时间 |
设备侧的可见性差别很大。锐应的 8+4 口千兆工业交换机(PoE 可选)在网管界面里提供了分类的 CPU 占用和上送报文计数,配合 工业交换机 产品线的 CoPP 配置,可以在广播风暴发生前就看出趋势;如果是 PON 网络,锐应 PON 与 OLT 方案 里的 OLT 侧也有类似的 CPU 与上送统计。
看趋势。稳定在 80% 说明余量只剩 20%,一次广播风暴或一轮 SNMP walk 就能推到 100%。建议以 60% 为预警线,超过就查上送分类计数,找出占比最大的那类协议。
因为 SSH 报文同样要 CPU 处理,而 CPU 已经被广播报文占满,管理连接排不上队。这也是必须配 CoPP 的理由——给管理面留一条独立通道,哪怕只有 10 pps。
不是。低端盒式机可能用 SoC 集成两者,但逻辑上仍是两条路径。高端机型是独立 ASIC 加独立 CPU。判断方法:拔掉管理网线,业务是否照常转发——照常就说明转发不依赖 CPU。
按协议分开设,基准是"正常业务峰值 × 1.5"。BPDU 按端口数乘:60 个端口、每端口每 2 秒 1 个 BPDU,就是 30 pps,限速设 50 pps。ARP 按终端数算,500 台终端设 300–500 pps。
取决于芯片。部分平台在 MAC 表满后把未知单播转为上送,此时上送速率会随业务流量线性上升,CPU 几秒内打满。这类平台必须配 MAC 学习数目限制,避免表项被占满。
控制面被打满从来不是"CPU 性能不够",而是上送速率超出了设计预期。把上送分类计数摸清楚,给每类协议独立的限速桶,比换一台 CPU 更快的交换机有效。锐应科技的工业交换机在网管界面里直接暴露分类上送统计,便于定位。