判断该用哪一种,先看要保护什么:
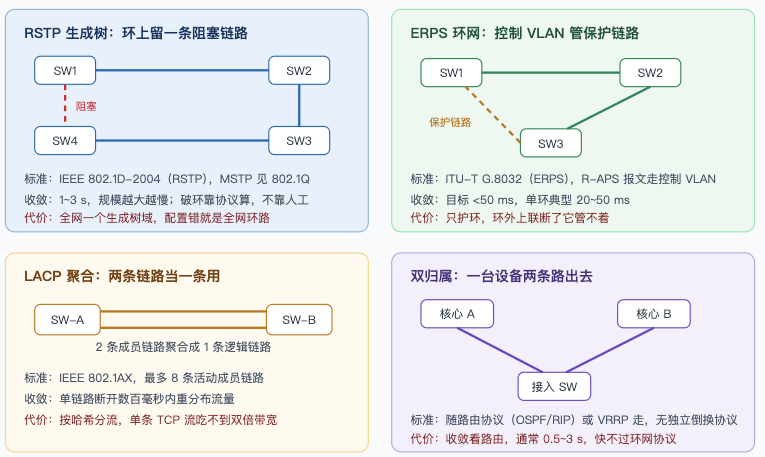
RSTP/MSTP:网络里存在物理环路,需要一个协议把环路软件断开,同时保证断开后还能恢复。保护对象是"环路引起的广播风暴"。
ERPS:环网拓扑,要求链路故障后 50 ms 级倒换。保护对象是"环上单点故障导致的业务中断"。
LACP:两台设备之间有多条链路,把它们捆成一条逻辑链路,兼顾带宽与单链路故障。保护对象是"链路本身"。
双归属:一台(或一组)设备有两条独立上联路径到两台核心设备。保护对象是"上行设备与链路"。
四者可以叠加,但叠加顺序和边界必须设计过,否则会互相打断。下面逐个拆。
RSTP 定义在 IEEE 802.1D-2004,把 STP 的机制从"定时器驱动"改成"握手驱动":端口通过 Proposal/Agreement 快速协商进入转发状态,不再死等 Listening 和 Learning 的定时器。典型收敛时间从 STP 的 30~50 s 降到 1~3 s。
MSTP(802.1Q 引入)在 RSTP 基础上支持多实例,可以把不同 VLAN 映射到不同生成树实例,实现"这条链路对 VLAN 10 是转发、对 VLAN 20 是阻塞"的负载分担。
代价集中在两处。第一,全网必须在一个生成树域里,边缘设备配置错(比如接了一台不支持 MSTP 的老交换机)就可能形成环路;第二,拓扑规模越大,收敛越慢,几十台规模的网络在极端情况下会接近 10 s。对生产控制类业务,这个时间通常不能接受。
ERPS 由 ITU-T G.8032 定义,是专门为环形拓扑设计的倒换协议。环上有一台设备作为 RPL Owner,负责阻塞保护链路;环上所有设备周期性发送 R-APS 报文(走控制 VLAN),链路故障时由 Owner 打开保护链路,业务流在毫秒级恢复。
标准目标是 50 ms,达成条件不算宽松:
环上设备数量有限(多数实现建议 16~20 台以内),节点越多报文处理越慢。
环上不能有超出预期的流量突发,控制报文需要优先发送。
单环配置简单,多环(相切环、相交环)配置复杂度陡增,需要规划子环与控制 VLAN。
节点数量多时建议分环,或用环间链路做分层。
ERPS 保护的是"环",环外的上联链路它管不着。所以环网设备通常还要配一条上行保护,那就是 LACP 或双归属的活。
另一条边界是恢复模式:Revertive 模式下故障恢复后业务会切回原路径,切换瞬间有二次扰动;Non-revertive 模式下故障路径恢复也不切换,长期运行在保护路径上,链路负载分配不均匀。生产网多用 Revertive,但要在验收时实测两次倒换(故障时和恢复时)。
LACP 定义在 IEEE 802.1AX(早期叫 802.3ad),把多条物理链路聚合成一条逻辑链路。要点:
最多 8 条活动成员链路,另有最多 8 条备用成员(Standby)。
流量按哈希分布,哈希因子通常是源/目的 MAC、IP、端口号的组合。同一个 TCP 流的所有报文哈希结果一致,因此单条流永远走同一条成员链路。
成员链路断开时,流量在数百毫秒内重新分布到剩余成员上,属于"无协议倒换"。
选型时最容易被误解的一点:2×GE 聚合不等于单条流能跑 2 Gbps。两台服务器之间做大数据传输,走的是同一条成员链路,实测仍是 1 Gbps 上下。只有多流并发(多客户端、多会话)才能体现出聚合带宽。
LACP 还有一个常见误判:聚合后链路断了一条,业务没中断,但丢了几十个报文。对视频监控影响不大,对工业控制协议可能会触发超时重连,验收指标要按业务写清楚。
双归属指一台交换机通过两条独立路径上联到两台核心设备。实现方式有两种:
动态路由:跑 OSPF 或 RIP,主路径断后由路由协议重新计算。收敛时间取决于协议参数,OSPF 在调优后可以到 1 s 以内,默认参数下通常 3~10 s 量级。
VRRP/静态路由:用 VRRP(RFC 5798)做网关冗余,配合静态路由与接口检测。切换时间可以做到亚秒级,但需要网络结构足够简单,否则容易出现回程路径不一致。
双归属的价值在于它保护的是"整台设备"而不是"一条链路"。交换机掉电、管理面死机、上联模块故障,LACP 都无能为力,双归属能救。代价是收敛最慢,且需要核心侧配合——如果两台核心设备之间没有互联,倒换过程中会出现短暂的单向不通。
场景:某厂区 8 台工业交换机组成 ERPS 单环,环上其中一台(汇聚点)通过 2×GE LACP 上联到核心交换机,核心侧双机 VRRP 冗余。业务要求单点故障时中断不超过 200 ms。
逐项拆预算:
第一步,环上链路故障。ERPS 单环、8 节点,实测倒换时间按 30~50 ms 计,取上限 50 ms。
第二步,上行聚合链路单条故障。LACP 把流量重分布到剩余成员,按 200~300 ms 计。这一项单独发生,不与环网故障叠加,因为上行链路故障时环内不触发倒换。预算取 300 ms —— 已超过 200 ms 的目标。
第三步,判断瓶颈。目标 200 ms 在这套结构下无法同时覆盖"上行单链路故障"这一场景。三个可选方案:
上行改为双归属(两条独立路径到两台核心),配合 OSPF 调优把收敛压到 1 s 内 —— 更慢,排除。
上行保持 LACP,但把验收指标按场景拆分:环上故障 ≤ 200 ms,上行链路故障 ≤ 500 ms。这是多数项目的实际做法。
上行改 4×GE 聚合,单条断开时流量分布到 3 条,重分布时间不变,但丢包量降低。
第四步,核对端到端时间。环上故障场景:ERPS 50 ms + 末级交换机 MAC/ARP 表刷新约 10 ms + 业务侧重传 20~50 ms,合计 80~110 ms,满足 200 ms 要求。上行场景:LACP 300 ms + 核心路由收敛(若跨设备)0~1 s,最坏情况接近 1.3 s,只能作为"可接受中断"处理。
结论:200 ms 的指标必须按场景定义。写"任意单点故障 200 ms 内恢复"在 LACP 上联的结构里做不到,签合同前要把两类场景分开写。
| 组合 | 是否推荐 | 说明 |
|---|---|---|
| ERPS 环 + 上行 LACP | 推荐 | 环内快速倒换、上行带宽与单链路保护,职责不重叠 |
| ERPS 环 + 上行双归属 | 推荐 | 多用于核心侧双机,收敛慢于 LACP,但保护范围更大 |
| RSTP 与 ERPS 同网 | 有条件 | 必须保证 ERPS 保护 VLAN 不在生成树域内,否则两套破环机制互相干扰 |
| LACP 与 ERPS 同链路 | 不推荐 | 聚合链路作为环的一段时,成员抖动会让 ERPS 误判环状态 |
| MSTP 多实例做负载分担 + ERPS | 不推荐 | 同一 VLAN 被两套机制接管,故障时会出现环路或长时间不通 |
| 双归属 + LACP 同时上 | 推荐(需设计) | 双归属走设备级、LACP 走链路级,两级都要有明确的收敛预期 |
| 方案 | 标准 | 典型收敛 | 适用拓扑 | 主要代价 |
|---|---|---|---|---|
| RSTP/MSTP | IEEE 802.1D-2004 / 802.1Q | 1~3 s,大规模更慢 | 任意有环拓扑 | 全网一个生成树域,配置错即环路 |
| ERPS | ITU-T G.8032 | 20~50 ms(单环、节点少) | 环形 | 只管环,多环配置复杂 |
| LACP | IEEE 802.1AX | 200~300 ms 重分布 | 点对点多条链路 | 单流不加速,需两端一致 |
| 双归属 | 随 OSPF/RIP/VRRP | 0.5~3 s | 双核心结构 | 收敛最慢,需核心侧配合 |
倒换时间按场景分别定义:环上故障、上行链路故障、设备掉电三类分开写指标。
现场实测至少两次倒换:故障发生一次,故障恢复(Revertive 模式)再测一次。
丢包数而不只是时间:200 ms 内丢 3 个包和丢 300 个包,业务感受完全不同。
检查 ERPS 控制 VLAN 与业务 VLAN 隔离,控制报文不能被限速或丢弃。
LACP 两端参数(模式、速率、超时)一致,否则会反复协商。
双归属场景下确认回程路径,避免"去的时候走 A、回来走 B"造成的单向不通。
锐应科技的工业交换机在 ERPS、RSTP/MSTP 与 LACP 上提供统一的配置口径,8+4 口机型的端口与上联能力见 工业交换机方案页;OLT 侧的双归属与 PON 保护倒换可参考 PON 接入方案,产品线概览见 关于锐应。
看拓扑。ERPS 只管环,环外的树形分支如果有冗余链路,仍然需要 RSTP 或 MSTP 破环。两者共存的关键是 VLAN 隔离:把 ERPS 保护的业务 VLAN 从生成树实例中排除,避免同一对端口被两套机制同时控制。混用时配置顺序也会影响结果,建议先起 ERPS 再起生成树。
因为单条 TCP 流的报文哈希结果固定,只会走其中一条成员链路。聚合提升的是多流并发时的总带宽和可靠性,不是单流速率。想验证聚合是否生效,用多线程并发打流,观察总吞吐是否接近 2 Gbps,同时检查两端端口流量是否接近均衡。
常见原因有三个:环上节点数量超出实现建议值,控制报文排队;环上存在大流量突发,R-APS 报文被延迟发送;环上有不支持 G.8032 的过渡设备,报文需要经过软件转发。先数节点,再看环上流量峰值,最后确认所有节点都是硬件转发 R-APS。
用普通路由协议很难。OSPF 需要邻居失效检测和 SPF 计算,即便把 Hello 和 Dead 间隔调到 3 倍关系,实际也在秒级。要压到 100 ms 以内,需要换用 PRP/HSR 这类并行冗余协议(IEC 62439-3),它们靠双份报文同时发送实现零切换,代价是带宽翻倍和设备必须成对支持。
G.8032 没有写死上限,但实现上受控制报文处理速度和单点转发时延限制。工程经验是单环控制在 16~20 台以内倒换时间比较稳定,超过这个数量建议拆成多环或改用分层结构。节点数量增加还会放大 R-APS 报文的处理负担,故障时的风暴抑制也要一起评估。
四种冗余的价值在于把"保护什么"讲清楚:RSTP 保护环路、ERPS 保护环网、LACP 保护链路、双归属保护设备出口。倒换时间预算必须按场景拆分,把 ERPS 的 50 ms 和 LACP 的 300 ms 混在一个指标里,投标时就会埋下验收争议。设计阶段多做一次分场景拆解,比事后调参数省事得多。