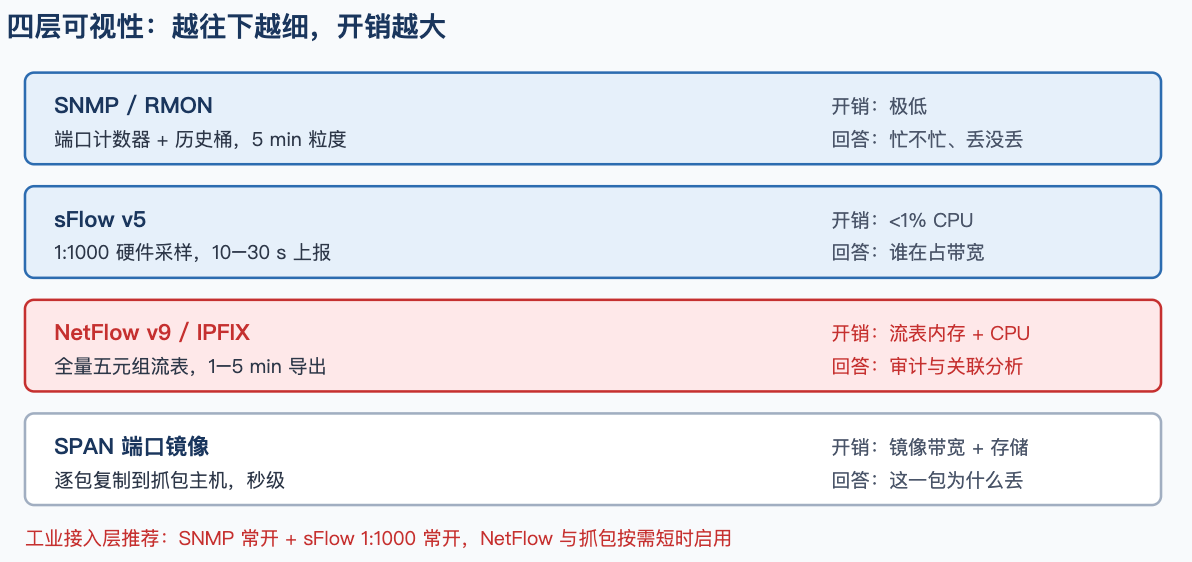
流量可视性不是一个功能,是四个层次。从端口计数器到逐包抓包,每一层的粒度提升一个量级,开销也提升一个量级。工业现场的约束是管理 CPU 通常只有几百兆赫兹,可用内存在百兆字节量级,选层选错的代价比选错设备更大。
RMON(RFC 2819,1991 年)解决的是"端口上发生了什么"。它定义九组 MIB:统计、历史、告警、主机、主机 TopN、矩阵、过滤、抓包、事件。核心是前四组——统计组给累计计数器,历史组按固定间隔采样存成桶,告警组在阈值越界时发事件。它不做流分析,只做计数。
sFlow(RFC 3176,2001 年)解决的是"流量构成是什么"。它在交换芯片里做硬件采样,按 1:N 的比例抽取报文,把报文头前 128 字节连同入端口、出端口、采样率打包成 UDP 报文发到采集端(默认 6343 端口)。采集端按采样率反推真实流量。它不维护流表,所以内存开销几乎为零。
NetFlow(v5/v9,后来标准化为 IPFIX,RFC 7011)解决的是"谁和谁在通信、通了多少"。它在设备上维护一张流表,每个五元组一条记录,流量结束时导出。信息最全,代价是要内存和 CPU。
| 技术 | 标准 | 粒度 | 设备开销 | 典型采集周期 | 工业现场适用性 |
|---|---|---|---|---|---|
| RMON / SNMP | RFC 2819、RFC 2021 | 端口计数器 + 历史桶 | 极低 | 1–15 min | 高,几乎所有网管型支持 |
| sFlow | RFC 3176 | 1:512–1:4096 采样 | 低,硬件采样 | 10–30 s | 高,芯片支持的机型可用 |
| NetFlow / IPFIX | RFC 7011 | 全量五元组流 | 高,需流表内存 | 1–5 min | 低,接入层少见 |
| SPAN 抓包 | 无(厂商实现) | 逐包 | 中,镜像带宽 | 按需 | 中,故障定位时短时使用 |
绝大多数现场问题用 RMON 就够了,前提是问对问题。"这个口带宽跑满了没有"——看 ifInOctets 的增长率,5 分钟粒度的历史桶足够。"有没有丢包"——看 ifInDiscards 和 ifOutDiscards。"有没有错包"——看 ifInErrors 和 ifInCRCErrors。这三个问题覆盖了七成的日常排查。
RMON 的边界在"为什么"。计数器告诉你某个口 5 分钟内丢了 3000 个包,但不告诉你丢的是谁的包、什么协议、从哪来。要回答"为什么",必须往上走一层。
另一个边界是粒度。5 分钟的桶会把 3 秒的微突发完全平均掉。一条 1 Gbps 链路,5 分钟平均利用率 8%,看起来空闲,但每 30 秒有一次 100 ms 的满速突发——这种微突发在 RMON 历史里看不见,却足以打满交换芯片的出口队列。要抓微突发,历史桶间隔得设到 10 秒以内,代价是存储量涨 30 倍。
sFlow 的精度由采样率决定,关系可以量化。假设一条链路上某条流占总流量的比例是 p,采样率是 1:N,那么每秒采到的该流样本数 n = 总包速率 × p / N。估计值的相对误差约等于 1/√n。
这意味着采样率不能随便定,必须按"你想看清多小的流"倒推。想看占总流量 1% 的流,如果总包速率是 250k pps、采样 1:1000,这条流每秒只有 250000 × 1% / 1000 = 2.5 个样本,相对误差 1/√2.5 ≈ 63%。这条流到底占 1% 还是 0.4%,从数据上分不出来。
想看占 20% 的流,采样数变成 50 个/秒,误差降到 14%,够用了。所以 sFlow 1:1000 的实际能力边界是"识别 10% 以上的流量构成",用来找"谁在占满上行"很有效,用来做精细计费或小流分析不行。
提高采样率有直接代价。采样率从 1:1000 提到 1:100,样本数涨 10 倍,导出带宽也涨 10 倍。采集端的存储和解析压力同步涨 10 倍。这个账必须在部署前算,否则开了 sFlow 三天就把采集服务器写满。
| 采样率 | 样本数(@250k pps) | 可辨识最小流 | 相对误差(1% 流) | 导出带宽 |
|---|---|---|---|---|
| 1:4096 | 61 /s | 约 20% | 极高 | 约 98 kbps |
| 1:2000 | 125 /s | 约 12% | 约 90% | 约 200 kbps |
| 1:1000 | 250 /s | 约 10% | 63% | 约 400 kbps |
| 1:500 | 500 /s | 约 5% | 45% | 约 800 kbps |
| 1:100 | 2500 /s | 约 1% | 2% | 约 4 Mbps |
三个原因。第一是内存。流表每条记录约 64–100 字节,100k 并发流就是 10 MB,而工业交换机的可用内存常常只有几十兆。流表满了之后要么老化加速(丢信息),要么停止学习(丢流)。
第二是 CPU。流的创建、维护、老化、导出都要 CPU 参与,250k pps 的链路上每秒新建流可能上万条,这颗几百兆赫兹的 CPU 扛不住。
第三是价值密度。工业现场的流量构成非常固定:PLC 与 SCADA 之间的周期通信、摄像头到 NVR 的视频流、少量办公流量。知道了"哪条流占带宽"的意义不如园区网大,因为答案通常是可预期的。真正需要流级信息的时候,往往是安全事件排查,那种场景用 SPAN 抓包更直接。
NetFlow 真正的用武之地在出口路由器和数据中心汇聚,不在工业接入层。
一条 1 Gbps 上行链路,平均帧长 500 字节,峰值帧率 = 1×10⁹ / (500×8) = 250,000 pps。
sFlow 采样率 1:1000,得到 250 个样本/秒。每个样本封装约 200 字节(含 UDP/IP/以太网头),导出带宽 = 250 × 200 × 8 = 400 kbps。相对 1 Gbps 链路占 0.04%,可忽略;CPU 侧因为是硬件采样,开销低于 1%。
现在看三条不同规模的流:
占 1% 带宽的流 = 2500 pps,样本 2.5 个/秒,相对误差 63%。结论:只能判断"有这么一条流",量级不可信。 占 5% 的流 = 12500 pps,样本 12.5 个/秒,误差 28%。结论:能判断量级,误差偏大。 占 20% 的流 = 50000 pps,样本 50 个/秒,误差 14%。结论:可用于容量分析和告警。
要把 1% 的流看到 2% 以内的误差,需要 2500 个样本/秒,采样率得设到 1:100。此时导出带宽变成 4 Mbps,采集端每秒要解析 2500 条记录。这个开销在工业交换机上已经开始影响管理面响应,需要评估。
所以部署 sFlow 的实用建议是:日常 1:1000 做趋势和 TopN,怀疑某条小流出问题时临时提到 1:100 做短时抓取,两者不要同时长期开着。
判断顺序建议从下往上,能用低层解决就不往上走。
只要知道"端口忙不忙、有没有丢包",用 SNMP/RMON,采集周期 1 分钟,几乎零成本。要回答"谁在占带宽",上 sFlow,采样 1:1000,周期 30 秒。要做安全审计或跨设备关联,才考虑 NetFlow/IPFIX,而且部署在汇聚或出口,不要下沉到接入。要定位具体某次丢包的报文内容,用 SPAN 抓包,抓完就关。
部署位置也有讲究。sFlow 采集点应该选在"流量汇聚处",比如上行口或核心互联口,而不是每个接入口都开——接入口流量小,采样样本更少,误差更大。采集端放在管理 VLAN 里,用独立的采集服务器,别让交换机自己兼做采集。
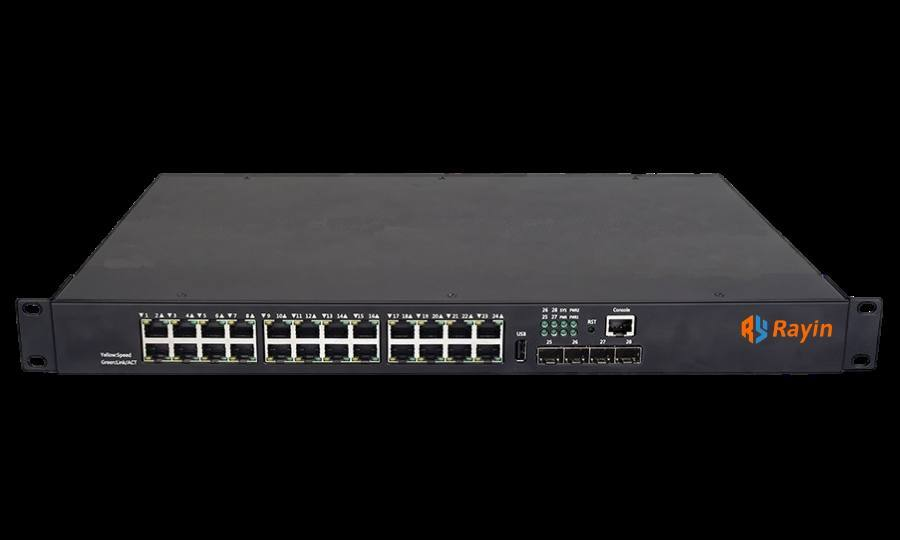
设备侧的支持差异很大。锐应的 8+4 口千兆工业交换机(PoE 可选)支持 RMON 四组和 sFlow 采样,配合 工业交换机 产品线的网管界面,可以在不额外部署探针的情况下拿到端口级和流级两层数据;如果是 PON 接入场景,锐应 PON 与 OLT 方案 里的 OLT 侧统计可以直接对应到每个 PON 口和 ONU,颗粒度比交换机侧更细。
常见原因是芯片不支持硬件采样,只能软件采样。软件采样在 250k pps 下会把 CPU 打满。查产品规格里"硬件采样"这一项,没有就只能用 RMON。
会。sFlow 是统计采样,一次持续 200 ms 的突发在 1:1000 下可能一个样本都采不到。抓突发要靠 10 秒以内的 RMON 历史桶,或者直接看 ifOutDiscards。
开源的有 sFlowTrend、nfdump 配合 sflowtool,商业的有各家网管平台。关键是采集端要能按采样率还原真实流量,配置里采样率填错会导致所有数据差 10 倍。
IPFIX(RFC 7011)由 NetFlow v9 标准化而来,报文结构基本一致,加了企业自定义字段和更严格的模板管理。两者在采集端通常能互相解析。
需要,但采样率取 1:1000 就够。它的开销低到可以常开,价值在于事后回溯——出问题时能查到"过去两小时谁在占带宽",这是 RMON 给不了的。
可视性选层的判断标准是"你要回答哪个问题",不是"哪个技术更先进"。工业现场九成的问题用 RMON 加 sFlow 就能定位,NetFlow 和抓包留给真正的疑难。锐应科技的工业交换机把这两层数据做进了网管界面,减少额外部署探针的成本。